您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MS SQL 資料庫
SQL Server 2008 億萬級數據性能優化實戰:從關聯查詢到覆蓋索引的極致優化之路
問題背景:關聯查詢的性能瓶頸
在某個百萬級甚至億級數據量的系統中,主表 zhubiao 儲存關鍵詞及其百度指數,子表 zibiao 儲存關鍵詞對應的 URL、排名、流量等詳細信息。常見的查詢需求是:根據特定來源(如百度知道)查詢關鍵詞,並按百度指數降序、排名升序返回 Top 1000。
SELECT TOP 1000 a.word, a.queryurl, a.irank, a.title, a.baiduurl, a.itraffic1, a.itraffic2, b.ibaiduindex
FROM zibiao a WITH(NOLOCK)
INNER JOIN zhubiao b WITH(NOLOCK) ON a.word = b.word
WHERE a.queryurl = 'https://zhidao.baidu.com'
ORDER BY b.ibaiduindex DESC, a.irank;
該查詢執行時間極不穩定,快則秒出,慢則需數分鐘。分析執行計劃發現,核心開銷集中在主表 zhubiao 的聚集索引查找上。子表通過 queryurl 篩選出關鍵詞後,需逐個回主表查找 ibaiduindex,隨機 I/O 開銷巨大。

錯誤的嘗試:讀寫分離與硬體升級
初以為是高頻更新導致索引碎片,嘗試發布訂閱做讀寫分離,將查詢轉移到備庫,但性能無提升。後又升級硬體(RAID 10 SSD、128GB 記憶體),問題依舊。這說明瓶頸不在 I/O 吞吐,而在查詢模型與索引設計上。
轉折點:冗余字段與覆蓋索引
社區專家建議將主表的 ibaiduindex 冗余到子表,消除 JOIN。驗證發現,子表單獨按 irank 排序極快(有索引)。於是決定:
- 將
ibaiduindex加入zibiao並同步更新; - 建立精心設計的組合覆蓋索引。
優化後的查詢與執行計劃
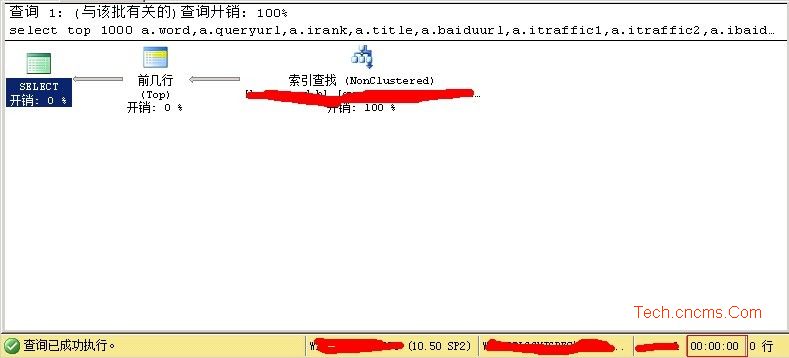
SELECT TOP 1000 a.word, a.queryurl, a.irank, a.title, a.baiduurl, a.itraffic1, a.itraffic2, a.ibaiduindex
FROM zibiao a WITH(NOLOCK)
WHERE a.queryurl = 'https://zhidao.baidu.com'
ORDER BY a.ibaiduindex DESC, a.irank;查詢瞬間完成。新執行計劃顯示:單次非聚集索引查找,無排序操作,無鍵值查找。
索引設計的關鍵細節(核心幹貨)
為何同樣是組合索引,效果卻天壤之別?關鍵在於三個維度的精準把控:
1. 索引鍵列順序:Where > Order By > Select
- 第一列:
queryurl—— 等值篩選列,放最左滿足 SARGable,快速定位數據範圍。 - 第二列:
ibaiduindex—— 首要排序列(DESC)。 - 第三列:
irank—— 次要排序列(ASC)。
順序錯誤(如把排序列放前面)會導致索引無法用於篩選,退化為掃描。
2. 索引排序方向必須與 ORDER BY 完全一致
定義索引時需顯式指定:ibaiduindex DESC, irank ASC。若預設均為 ASC,優化器無法利用索引順序,需額外排序,耗時從毫秒級飆升至秒級。
3. 包含列:實現真正的覆蓋索引
查詢輸出列(word, title, baiduurl, itraffic1, itraffic2)均非索引鍵列。若無 INCLUDE,查找到索引葉節點後仍需回表(Key Lookup)獲取這些列,產生大量隨機 I/O。加入 INCLUDE 後,葉節點直接攜帶所有所需列,實現純索引掃描,零回表。
CREATE NONCLUSTERED INDEX IX_zibiao_Covering
ON zibiao (queryurl, ibaiduindex DESC, irank ASC)
INCLUDE (word, title, baiduurl, itraffic1, itraffic2);
代價與總結
優化代價:索引體積增加數十 GB。但換取的是查詢從「分鐘級」穩定至「毫秒級」,且無鎖爭用風險(NOLOCK)。
核心心法:大數據量下,消除 JOIN > 覆蓋索引 > 硬體升級。索引設計須精準對齊「篩選-排序-輸出」三部曲,任何一環疏漏,優化皆落空。
推薦文章
- SQL Server 2008 億萬級數據性能優化實戰:從關聯查詢到覆蓋索引的極…
- SQL Server 數據按類別批量匯出為多個 Excel 檔案:WHILE 迴…
- SQL Server 動態交叉表 (Crosstab) 存儲過程:游標遍歷屬性列…
- SQL Server 分頁查詢最佳實踐:ROW_NUMBER() 完整用法與存儲…
- SQL Server 批量生成 INSERT 腳本存儲過程增強版:支援條件導出、…
- SQL 進階技巧:CROSS APPLY 實現分組取 Top N 百分比資料
- SQLite 入門三:.mode/.headers/.separator 等常用…
- SQL Server 2008 產生資料腳本快速入門:三步驟匯出結構與資料
- C# 封裝 ADO.NET 通用資料存取類 MyDBase 實作教學
- SQL Server 行列轉換完全指南:動態 PIVOT/UNPIVOT、CAS…