您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MySQL 教學
深度解析:無共享存儲下如何實現數據庫強一致性與高可用
在分佈式數據庫架構中,如何在不依賴共享存儲的前提下實現主備數據的強一致性、高可用性與高性能,始終是技術團隊攻關的核心課題。本文將從原理層面深度剖析這一經典問題,涵蓋 WAL 強同步機制、基於 Lease 的 HA 架構、Paxos/Raft 共識協議應用、多副本性能優化以及極端故障場景下的數據一致性保障。
背景:一條微博引發的技術大辯論
事情始於陽老師(@阿裡正祥)的一條微博,引發了國內數據庫圈層的激烈討論:在不使用共享存儲的情況下,傳統 RDBMS(如 Oracle、MySQL、PostgreSQL)能否在主庫故障時做到數據零丟失? 團隊內部經過多輪辯論,最終將討論聚焦於四大核心問題:數據一致性、分區可用性、性能損耗與極端場景分析。
問題一:數據一致性——WAL 強同步機制
結論:完全可以實現主備強一致。 核心在於 Write-Ahead Logging (WAL)。事務提交時,同時發起兩個寫日誌操作:一個寫本地磁盤,另一個同步發送至備庫並確保落盤。主庫等待雙方均成功返回後,才向應用確認提交成功。
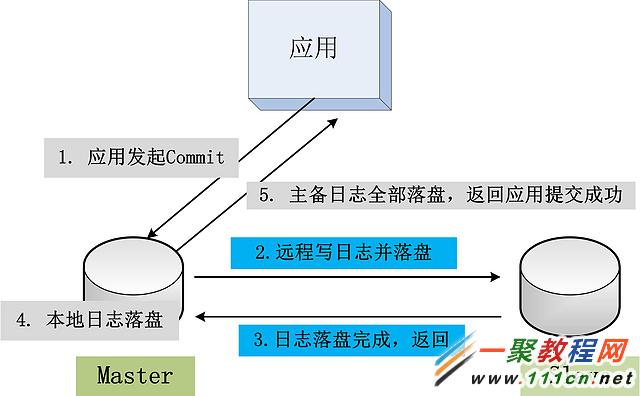
此時主備雙方均持有該事務日誌,即為強同步。若主庫 Crash,備庫接管服務,數據零丟失。Oracle Data Guard 的「最大保護模式」即採用此架構。
問題二:分區可用性——引入 Lease 機制與 Paxos/Raft
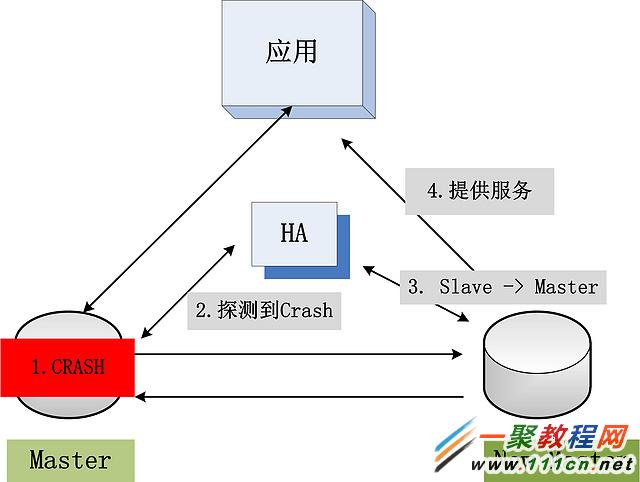
單純的主備強同步 + 傳統 HA 工具存在三大隱患:
- 單點風險:主備切換後,原主庫恢復前系統處於單點狀態。
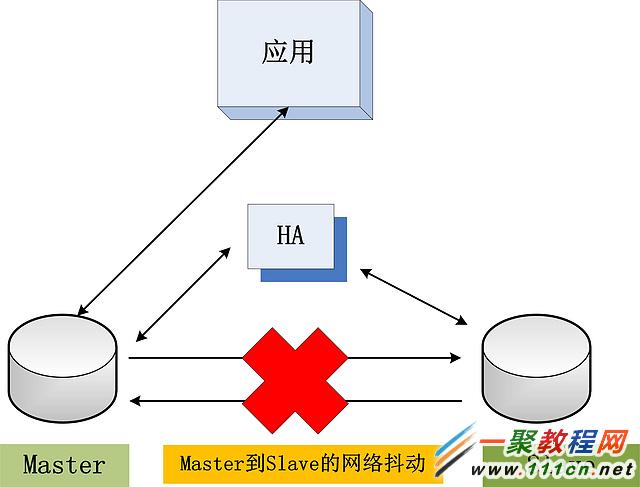
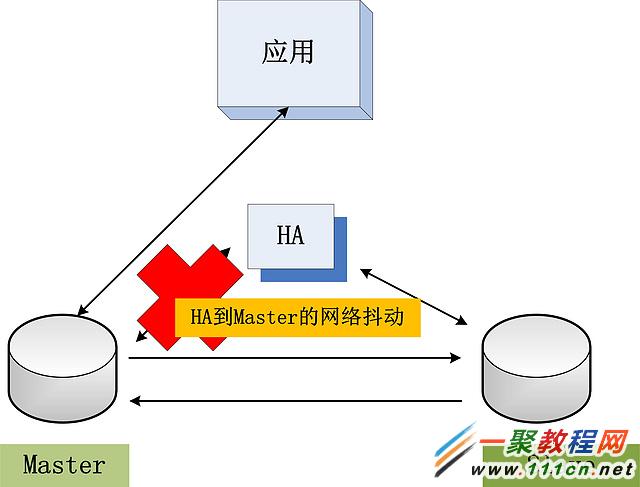
- 網絡分區誤判:HA 無法區分「主庫掛了」還是「HA 與主庫網斷了」,易導致雙主(Split-brain)。
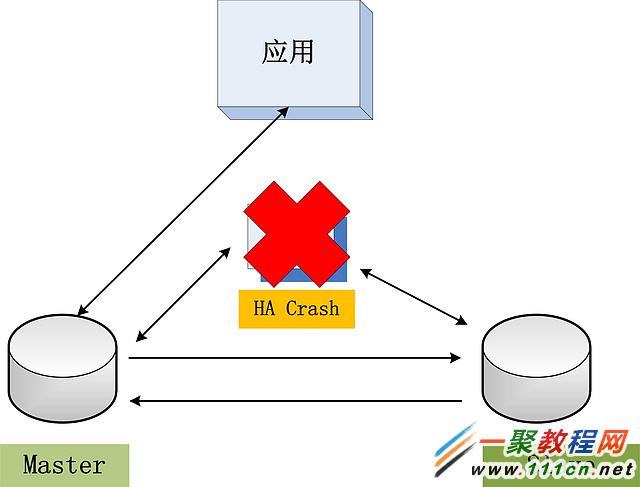
- HA 自身單點:誰來保證 HA 的高可用?
解決方案:多節點 HA + Lease 租約機制
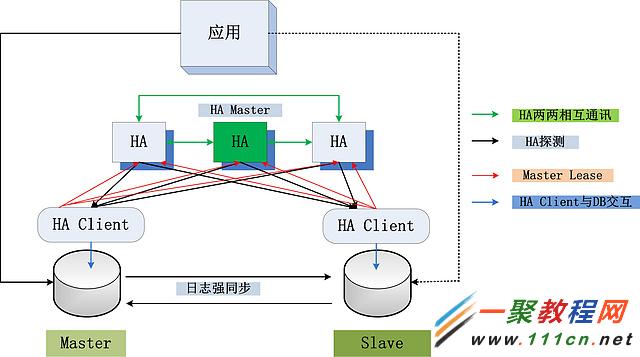
架構升級點:
- DB 節點部署 HA Client,負責與 HA 叢集心跳、續租。
- HA 由單節點擴展為 3 節點叢集,通過 Paxos/Raft 自動選主,解決 HA 自身高可用。
- 引入 Master Lease(主庫租約):主庫需定期(如每 10 秒)向 HA Master 續租。若超時未收到續租,HA Master 判定主庫失效,提升備庫。
三大故障場景分析
| 場景 | 現象 | 處理邏輯 |
|---|---|---|
| 主庫 Crash,主機正常 | HA Client 存活 | Client 主動釋放租約,HA Master 秒級切換備庫。 |
| 主庫主機 Crash | Client 與 DB 同時失聯 | HA Master 等待租約超時(如 12 秒)後切換,避免誤判網絡抖動。 |
| 主庫正常,但與 HA Master 網絡斷開 | Client 續租失敗 | Client 超時後主動降級為備庫;HA Master 同步提升原備庫。雙主問題徹底杜絕。 |
此架構下,系統最多不可用時間 = 租約時長(可配置為秒級),實現了分區容錯下的持續可用。
問題三:性能——強同步下的吞吐量優化
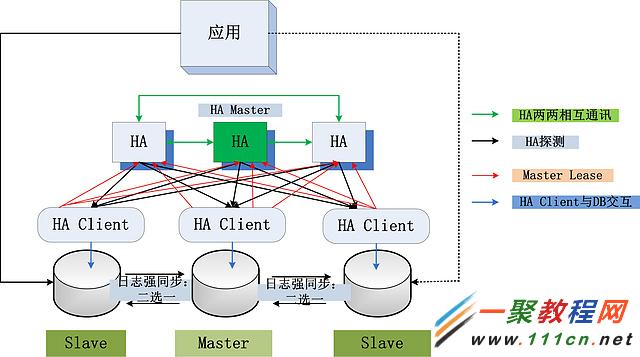
強同步會增加一次網絡 RTT 與一次遠端磁盤 fsync,導致單事務延遲上升。優化策略:
- 多副本部署(如 1 主 2 備):只要任一備庫同步完成即返回,極大降低網絡抖動影響,且消除主庫 Crash 後的單點風險。
- 新主選擇策略:優先選日誌最新的副本;若一致則按 IP 大小等確定性規則選擇。
- 異步化關鍵路徑:將日誌寫入、網絡發送、鎖操作等關鍵路徑無鎖化、管道化,確保單事務 RT 增加,但系統整體吞吐量不下降(CPU 不增加額外開銷)。
問題四:極端場景——Commit 過程中主庫崩潰怎麼辦?
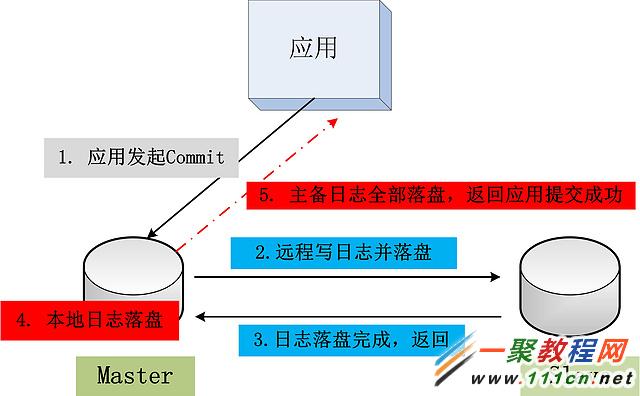
若主庫在步驟 4(備庫落盤完成)前或步驟 5(主庫返回應用)前崩潰,備庫已有日誌,主庫可能有也可能無。此時系統如何處理?
專家觀點摘要
@淘寶丁奇:本質等同於單庫場景下「事務提交完成,返回 ACK 前崩潰」。客戶端未收到明確成功/失敗,屬於「臨界事務」,應用層需通過重試、冪等 ID 或查詢狀態來處理。
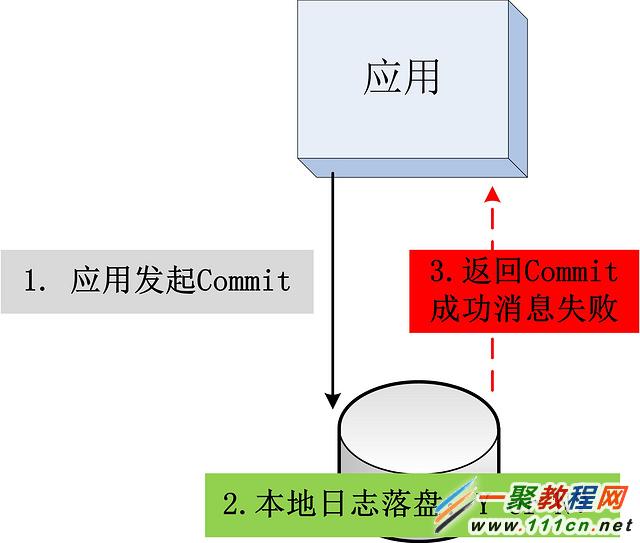
@ArthurHG:關鍵在服務端達到一致。可讓新主從備庫同步,或讓備庫回滾。客戶端重試時需保證冪等(分配唯一事務 ID)或先查後寫。
總結
- 強一致性:主流 RDBMS(Oracle、MySQL 5.7、阿里雲 RDS、網易 RDS)均可通過 WAL 強同步實現,不依賴共享存儲。
- 高可用 + 高性能:理論可行,但工程複雜度極高,需深度整合共識協議、Lease 機制、多副本優化,目前主流開源數據庫鮮有完整落地者。
能讀到這裡的朋友,都是真愛!歡迎繼續探討交流。
- 上一篇程序編程: 阿里巴巴數據庫選型實戰:Oracle vs MySQL vs NoSQL 三步決策模型
- 下一篇程序編程: MySQL InnoDB 加鎖機制與死鎖分析全攻略
推薦文章
- MySQL 四捨五入函數完全指南:ROUND、FLOOR、CEILING 實戰範…
- MySQL 查找與刪除重複資料完整指南 (單欄、多欄、存儲過程)
- 關閉 MySQL/MariaDB Binlog 並清理歷史日誌文件操作指南
- MySQL 字符串拼接函數大全:CONCAT、CONCAT_WS、GROUP_C…
- MySQL 啟動、停止、重啟的多種方法與官方推薦最佳實踐
- SQL 彙總函式:MAX() 最大值與 MIN() 最小值
- CentOS 5.5 編譯安裝 MySQL 5.5.37 完整實戰記錄:CMak…
- MySQL my.ini 配置參數深度解析與效能調校實戰
- 解決 PHP 連接 MySQL 4.1+ 亂碼問題:字符集配置全流程
- FreeBSD 升級 MySQL Client 兩種實戰方案:Portmaste…