您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 網路程式設計 >> 程式語言綜合
Nginx 封鎖特定 User-Agent 的完整教學與黑名單管理實戰
現代網路環境中,惡意機器人與網頁爬蟲層出不窮——從惡意軟體機器人、垃圾郵件收集程式到內容刮取工具,它們潛伏在網站間掃描漏洞、竊取郵件地址或盜取內容。大多數機器人可透過「User-Agent」特徵字串識別,而 Nginx 作為高效能 Web 伺服器,提供了靈活的封鎖機制,讓我們能在第一道防線攔截這些威脅。
為什麼 robots.txt 不夠用?
雖然在 robots.txt 中列出惡意 User-Agent 可阻擋「守規矩」的爬蟲,但絕大多數惡意機器人會直接無視此協定,繼續肆意掃描。因此,必須在 Web 伺服器層面直接拒絕請求,才能真正有效防禦。
方法一:直接在 server 區塊撰寫封鎖規則
打開網站的 Nginx 設定檔(常見路徑:/etc/nginx/nginx.conf、/etc/nginx/sites-enabled/your-site 等),在 server 區塊內加入 if 判斷:
server {
    listen 80 default_server;
    server_name example.com;
    root /usr/share/nginx/html;

    # 大小寫敏感匹配
    if ($http_user_agent ~ (Antivirx|Arian)) {
        return 403;
    }

    # 大小寫不敏感匹配
    if ($http_user_agent ~* (netcrawl|npbot|malicious)) {
        return 403;
    }
    ...
}
$http_user_agent 變數保存請求的 User-Agent 字串;~ 為大小寫敏感正則匹配,~* 則為不敏感;| 代表邏輯「或」,可一次列出多個關鍵字。修改完成後,執行 sudo nginx -s reload 重新載入生效。
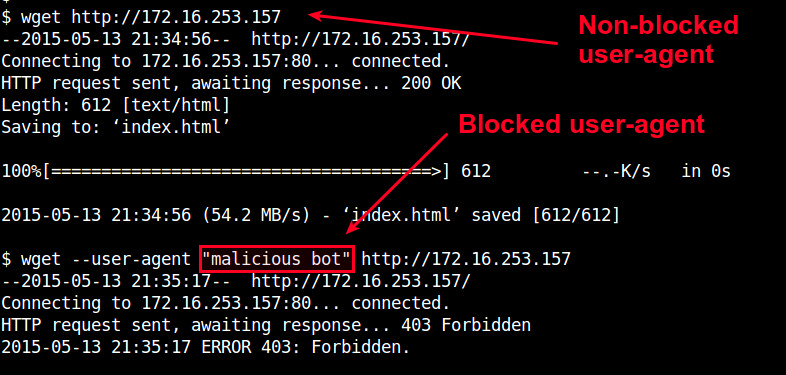
方法二:建立獨立黑名單檔案方便維護(推薦)
當封鎖清單龐大時,直接寫在 server 區塊不利維護。建議建立獨立規則檔 /etc/nginx/useragent.rules:
map $http_user_agent $badagent {
    default 0;
    ~*malicious 1;
    ~*backdoor 1;
    ~*netcrawler 1;
    ~Antivirx 1;
    ~Arian 1;
    ~webbandit 1;
}
default 0 表示未列入清單的 User-Agent 預設允許通行。接著在 http 區塊(必須在 server 之前)引入此檔:
http {
    ...
    include /etc/nginx/useragent.rules;
}
最後在 server 區塊加入判斷:
server {
    ...
    if ($badagent) {
        return 403;
    }
    ...
}
再次 nginx -s reload 即可啟用。此架構讓黑名單管理更清晰、擴充更彈性,是生產環境的最佳實踐。
- 上一篇程序編程: Python 描述符協定深度解析:從 property 到可重用屬性的演進
- 下一篇程序編程: C 語言陣列與指標的組合語言深度解析:從原始碼到機器碼的效能差異
推薦文章
- jQuery extend() 與 fn.extend() 深度解析:插件開發核…
- Ruby 實用技巧:解構賦值、Hash#fetch、預設值 Hash、sort_…
- WordPress 後台使用者搜尋增強:支援顯示名稱、暱稱、Email
- Python 內建文檔神器 pydoc 完整使用指南:從終端機到網頁文檔一鍵生成
- PyMongo 為 MongoDB 創建唯一索引:一行代碼搞定
- Notepad++ 正則表達式實戰速查:查找、替換、刪除空行、多行處理
- 使用者名稱驗證正則:純字母、字母數字混合或純中文,長度限制
- 原生 JavaScript 實作 AJAX 完整教學:從 XMLHttpRequ…
- Visual Studio 2010 完整快捷鍵大全 (含 VS2008/200…
- Python gevent 協程框架入門:猴子補丁、綠色執行緒與自動 IO 切換…
copyright © 萬盛學電腦網 all rights reserved