您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MySQL 教學
FriendFeed 無模式數據架構:用 MySQL 實現 Schema-less 存儲與動態索引
面對 2.5 億+ 記錄、頻繁 Schema 變更導致的 DDL 鎖表數小時、索引維護擠佔緩存等痛點,FriendFeed 摒棄傳統關係模型,在 MySQL 上構建了一套無模式存儲 + 獨立索引表 + 異步清理器架構。本文詳述實體表設計、索引表自動維護、一致性妥協與清理機制、分片策略、性能實測數據,為大規模動態業務提供參考。
核心痛點
- 超 1000 萬行表加索引/改 Schema 鎖表數小時
- 舊索引不刪佔用緩存、拖慢寫入;刪除同樣鎖表
- 主從切換、在線 DDL 工具(如 pt-online-schema-change)操作複雜、易出錯
- 業務已分庫分表,Join 無意義,不需要強關係特性
架構總覽
- 實體表:僅存
id (UUID)+body (壓縮 JSON)+updated,Schema 固定不再變動 - 索引表:每個需查詢的屬性建一張獨立表,如
index_user_id(user_id, entity_id) - 清理器進程:異步回填缺失索引、清理失效索引,優先處理近期更新實體,秒級收斂
實體表設計
CREATE TABLE entities (
    added_id INT NOT NULL AUTO_INCREMENT PRIMARY KEY,  -- 物理順序寫入優化
    id BINARY(16) NOT NULL,                            -- UUID,業務主鍵
    updated TIMESTAMP NOT NULL,
    body MEDIUMBLOB,                                   -- zlib 壓縮後的 Python dict/JSON
    UNIQUE KEY (id),
    KEY (updated)
) ENGINE=InnoDB;
added_id保證新實體順序追加,利於分區讀取(新數據訪問更熱)- 實體內部結構對 DB 不可見,應用層序列化/反序列化
索引表設計
以 user_id 索引為例:
CREATE TABLE index_user_id (
    user_id BINARY(16) NOT NULL,
    entity_id BINARY(16) NOT NULL UNIQUE,
    PRIMARY KEY (user_id, entity_id)
) ENGINE=InnoDB;
查詢流程:
- 從所有分片的
index_user_id取entity_id列表 - 回
entities表按id批量取實體 - 應用層用真實屬性二次過濾(索引可能臨時不一致)
動態索引管理
新增索引(如 link 欄位)
-- 1. 建索引表
CREATE TABLE index_link (
    link VARCHAR(735) NOT NULL,
    entity_id BINARY(16) NOT NULL UNIQUE,
    PRIMARY KEY (link, entity_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

-- 2. 代碼註冊索引
link_index = Index(table="index_link", properties=["link"], shard_on="link")
datastore = DataStore(mysql_shards=["127.0.0.1:3306", "127.0.0.1:3307"],
                      indexes=[user_id_index, link_index])

-- 3. 異步回填歷史數據(不阻塞線上服務)
./rundatastorecleaner.py --index=index_link
刪除索引
- 代碼停寫該索引表
- 可選:異步
DROP TABLE釋放空間
一致性與原子性:妥協與補償
核心原則:
- 實體表數據為準則(InnoDB ACID 保證)
- 索引表不影響實體真實值,允許短暫不一致
寫入流程:
- 事務寫入
entities(主表) - 異步寫入各分片索引表(可能部分失敗、延遲)
讀取糾偏:
- 從索引表獲取候選
entity_id - 回實體表讀取完整
body - 應用層用真實屬性過濾,剔除臟讀
清理器 持續運行:優先處理最近更新實體,秒級修復索引缺失/殘留。
性能實測
上線後頁面加載延遲顯著下降並趨於穩定(見下圖):
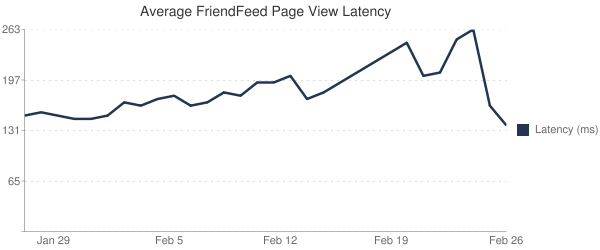
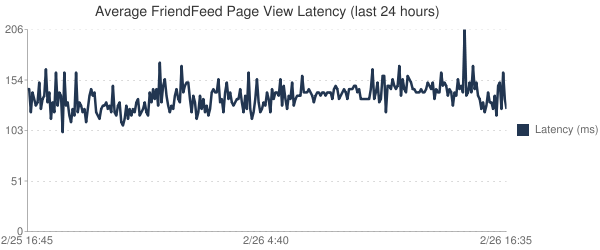
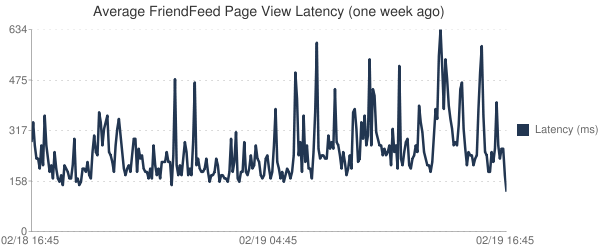
- 尾部延遲大幅收斂,高峰期也穩定
- 新增索引從「天級風險操作」變為「一日內安全完成」
- 開始將模式推廣至其他大表
啟示
- 業務若不依賴 Join/事務/外鍵,MySQL 可作「帶 B+ 樹索引的 KV 存儲」
- 將 Schema 遷移壓力轉移到應用層(序列化)與異步進程(清理器)
- 索引即表,索引增減 = 建表/刪表,規避 DDL 鎖表
- 最終一致性換取寫入高可用,應用層二次過濾保證語義正確
- 上一篇程序編程: Coreseek (Sphinx + 中文分詞) 安裝配置與 PHP 整合實戰
- 下一篇程序編程: 關閉 MySQL/MariaDB Binlog 並清理歷史日誌文件操作指南
推薦文章
- MySQL 多級分類儲存方案對決:遞歸遞歸 vs 左右值(Nested Set)
- MySQL 中文排序錯誤解決方案:字符集、COLLATE、CONVERT 三大招
- MySQL 鎖機制全景解析:表鎖、頁鎖、行鎖與死鎖應對
- MySQL 多字段關鍵詞模糊查詢:CONCAT + LIKE 實戰技巧
- CentOS 7 從源碼編譯安裝 MySQL 5.7/8.0:CMake 完整實…
- MySQL 百萬級數據批量刪除實戰:分批刪除、臨時表法與性能優化策略
- Windows MySQL 服務啟動錯誤 1069:登錄失敗解決方案
- SQL 技巧:用 REPLACE + LEN 快速統計長字串中某子字串出現次數
- MySQL 備份與還原五大實用方法總結:從物理複製到自動化腳本
- MySQL 避免重複插入三大方案:INSERT IGNORE、REPLACE、O…
copyright © 萬盛學電腦網 all rights reserved