您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 伺服器教學
Linux 核心檔案預讀機制深度解析:從磁碟特性到 page cache 架構
磁碟 I/O 效能遠落後於 CPU/記憶體,預讀是改善讀取效能的核心優化手段。本文深入剖析 Linux 核心(以 2.6.22 為基準)的預讀演算法演進、架構設計、徵序檢測、流水線預讀與隨機讀支援等關鍵技術。
儲存層級金字塔與預讀動機
從暫存器、L1/L2 快取、記憶體、快閃記憶體到磁碟/光碟/磁帶/儲存網路,容量遞增但速度遞減,形成逐層快取結構。預讀屬於預取範疇,旨在從慢速儲存預載資料到快取。
磁碟機械特性決定預讀必要性
- 定位階段:平均尋道 4.6ms + 旋轉延遲 4.2ms (7200 RPM) ≈ 8ms。
- 傳輸階段:持續傳輸率可達 80MB/s+。
小塊隨機 I/O(4KB)下,磁碟 99% 時間在定位,吞吐 < 500KB/s;大塊循序 I/O(1MB)吞吐逼近 50MB/s。**大塊 I/O 可提升磁碟利用率 100 倍**,預讀即透過聚合小 I/O 為大 I/O 實現此目標。

應用程式視角:隱藏 I/O 延遲
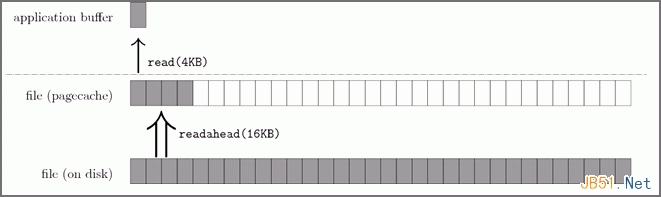
典型處理迴圈 while(!done) { read(); compute(); } 導致 CPU 與磁碟交替等待。預讀在 CPU 處理當批資料時,背景非同步預載下一批資料至 page cache,實現流水線並行,對應用程式隱藏磁碟延遲。


核心預讀 API
posix_fadvise(2):建議存取模式(POSIX_FADV_SEQUENTIAL、POSIX_FADV_RANDOM、POSIX_FADV_WILLNEED等)。readahead(2):直接發起非同步預讀。madvise(2):對映射記憶體區域建議。
多數應用無需直接呼叫,核心啟發式演算法已足夠優秀。
Linux 預讀架構演進
- 2.5 核心 (2002):Andrew Morton 在 VFS 層引入統一預讀框架,
page_cache為中心,read()從 cache 複製,預讀負責填充 cache。 - 2003:Linus 將
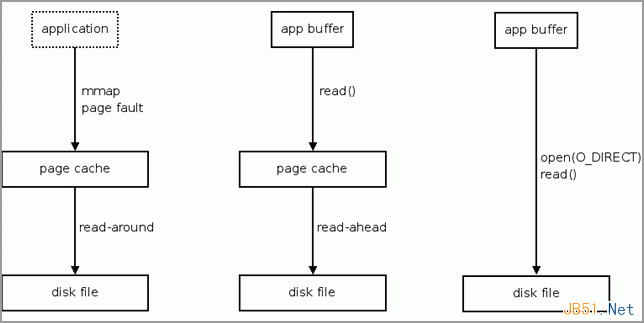
mmap缺頁預取獨立為 read-around(以當前頁為中心前後預取 128KB),readahead 專注read()循序存取。 - 2004:Steven Pratt、Ram Pai 等完善 readahead,關鍵改進:**監控完整
read()呼叫(偏移量+長度),精準區分循序/隨機讀**,解決隨機讀觸發誤判循序預讀導致命中率下降問題。
核心演算法要點 (2.6.22)
1. 循序性檢測
僅對循序讀預讀,滿足任一條件即判定為循序:
- 檔案開啟後首次讀取且讀檔案開頭。
- 目前讀請求與上一記錄讀請求在檔案內位置連續。
任何隨機讀即終止當前循序序列,停止預讀(而非縮減預讀量)。核心假設檔案在磁碟上大致連續儲存(無嚴重碎片)。
2. 流水線預讀
當程式處理當批資料時,核心背景發起下一批預讀 I/O,大小動態調整(通常 16~128KB),實現 CPU/磁碟並行。
3. 自適應預讀窗口
根據命中率動態調整預讀大小:命中率高則增大窗口,命中率低則縮小,平衡頻寬利用與快取污染。
read-around vs readahead
| 特性 | read-around (mmap) | readahead (read) |
|---|---|---|
| 觸發條件 | 缺頁中斷 | read() 系統呼叫 |
| 存取模式 | 強區域性 | 多為循序,亦存隨機 |
| 預取範圍 | 以當前頁為中心前後 128KB | 動態,依循序長度與命中率調整 |
| 隨機讀處理 | 不適用 | 明確識別並停止預讀 |
總結
Linux 預讀演算法遵循「保守循序、拒絕隨機」原則,透過 VFS 統一框架支援所有檔案系統,經過十餘年演進已極度成熟。理解其運作機制,有助於應用層透過 posix_fadvise 協助核心決策,或在儲存層面規劃 RAID 分條大小、快取策略以配合核心預讀行為,發揮最大效能。
- 上一篇程序編程: Linux blockdev 指令設定區塊裝置預讀大小與唯讀/可寫屬性
- 下一篇程序編程: RedHat 系統調整螢幕解析度:圖形介面與指令列雙軌教學
推薦文章
- TCP/UDP 網路程式設計完整流程與核心 API 詳解 (Socket 程式設…
- 釋放 C 槽空間 27 招:從清理暫存檔、移動資料夾到壓縮 NTFS、關閉休眠
- Ubuntu 系統如何修改預設語言?完整圖文教學
- Vista 檔案複製太慢?FastCopy 替代系統複製加速 30% 並整合右鍵…
- http_load 壓力測試工具安裝與使用全攻略(支援 HTTPS)
- Windows Server 2003/XP 安裝 IIS 6.0 圖文完整教程
- Windows 7 使用 PowerISO 製作 Ubuntu 12.10 可開…
- Linux VPS 配置 Nginx 反向代理存取 Twitter 完整實戰
- CentOS 目錄映射為 Windows 磁盤驅動器:Samba 共享與網絡驅動…
- Linux 磁碟 I/O 效能分析:iostat 指標深度解讀與瓶頸判斷