您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MySQL 教學
MySQL 多表關聯查詢優化實戰:從子查詢到 JOIN、緩存表與大數據分頁方案
百萬級數據下的多表關聯查詢是性能殺手。本文通過實測對比,揭示 EXISTS 子查詢性能陷阱,演示 INNER JOIN 改寫優化,系統講解 JOIN 類型、優化器行為、緩存表設計與分表聚合方案。
案例一:子查詢 vs INNER JOIN 實測對比
場景
table1:10 萬行(外層)table2:100 萬行(內層)- 關聯鍵:
uuid
方案 A:EXISTS 相關子查詢(慢)
SELECT * FROM table1
WHERE EXISTS (
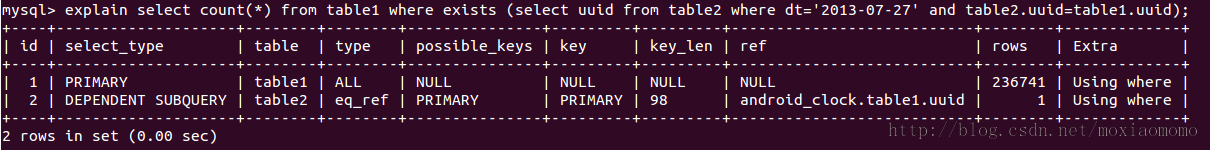
  SELECT * FROM table2 WHERE id >= 30000 AND table1.uuid = table2.uuid
);
耗時:2.40s
EXPLAIN 顯示:DEPENDENT SUBQUERY,外層全表掃描,內層逐行執行。
方案 B:INNER JOIN 改寫(快)
SELECT * FROM table1
INNER JOIN table2 USING (uuid)
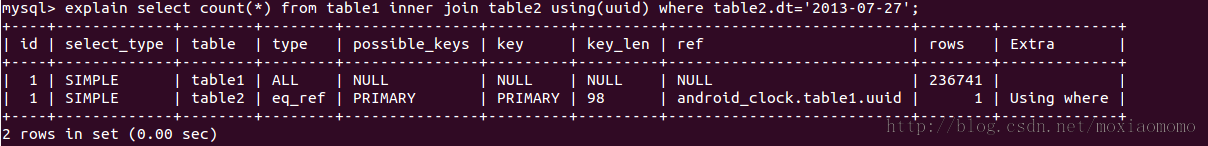
WHERE table2.id >= 30000;
耗時:0.68s(提升 3.5 倍)
EXPLAIN 顯示:SIMPLE 類型,優化器先過濾 table2 再關聯。
JOIN 類型完全指南
| 類型 | 語法 | 語義 | 結果集 |
|---|---|---|---|
| 交叉連接 | CROSS JOIN / JOIN / , | 笛卡爾積 | 極大,慎用 |
| 內連接 | INNER JOIN ... ON | 等值匹配 | 雙方都存在 |
| 左外連接 | LEFT [OUTER] JOIN ... ON | 左表全量 + 匹配 | 左表為準 |
| 右外連接 | RIGHT [OUTER] JOIN ... ON | 右表全量 + 匹配 | 右表為準 |
LEFT JOIN 執行機制
SELECT id, name, action
FROM user u
LEFT JOIN user_action a ON u.id = a.user_id;
原理:讀左表一行 → 匹配右表所有滿足 ON 條件的行 → 產生 N 行(含重複) → 右表無匹配則 NULL 填充。
利用 LEFT JOIN 找差集
SELECT u.id, u.name
FROM user u
LEFT JOIN user_action a ON u.id = a.user_id
WHERE a.user_id IS NULL;
-- 找出 user 表中有但 user_action 中無記錄的用戶
MySQL LEFT/RIGHT JOIN 優化器規則
- 根據左表及其依賴表設置右表
- 根據 LEFT JOIN 條件中使用的表(除右表外)設置左表
- ON 條件決定右表訪問方式(WHERE 不參與)
- 標準優化後,若左表行匹配 WHERE 但右表無匹配 → 生成 NULL 行
- 若 WHERE 條件為
右表列 IS NULL且該列NOT NULL,匹配到第一行即停止搜尋
JOIN 順序優化技巧
-- 低效:強制先讀 a,再 LEFT JOIN c,d,最後 WHERE b.key=d.key
SELECT * FROM a,b LEFT JOIN c ON (c.key=a.key) LEFT JOIN d ON (d.key=a.key)
WHERE b.key=d.key;

-- 高效:調整 FROM 順序,b 先讀
SELECT * FROM b,a LEFT JOIN c ON (c.key=a.key) LEFT JOIN d ON (d.key=a.key)
WHERE b.key=d.key;

-- 強制順序
SELECT * FROM b STRAIGHT_JOIN a LEFT JOIN c ...
索引提示:USE INDEX / IGNORE INDEX
SELECT * FROM table1 USE INDEX (key1,key2) WHERE key1=1 AND key2=2 AND key3=3;
SELECT * FROM table1 IGNORE INDEX (key3) WHERE key1=1 AND key2=2 AND key3=3;
大數據量業務優化:緩存表模式
場景:購物分享網站,核心表 6 張(分享、圖片、文件、評論、標簽、分類),詳情頁需聚合展示。
方案:主表冗餘緩存字段
ALTER TABLE share ADD COLUMN cache_data TEXT;

-- 寫入時序列化存入
$cache_data = [
  'img' => ['name'=>'123.jpg', 'url'=>'...', 'width'=>800, 'height'=>600],
  'file' => ['name'=>'abc.zip', 'download_url'=>'...', 'size'=>'1.2Mb'],
  'category' => [[ 'id'=>5, 'name'=>'PHP樂知博客'], ['id'=>6, 'name'=>'PHP技術博客']],
  'tag' => ['tag1','tag2'],
  'message' => [['id', 'uid', 'name', 'content', 'time'], ...]  -- 最新 10 條
];
UPDATE share SET cache_data = mysql_real_escape_string(serialize($cache_data)) WHERE id = 1;
讀取時反序列化
$row = $db->query("SELECT cache_data FROM share WHERE id=1");
$data = unserialize($row['cache_data']);
// 直接渲染模板,零 JOIN
分表聚合視圖方案
單表超 200 萬行性能下降時,按 id % 4 + 1 拆分為 news1~4:
CREATE ALGORITHM=TEMPTABLE VIEW news AS
SELECT * FROM news1 UNION ALL SELECT * FROM news2
UNION ALL SELECT * FROM news3 UNION ALL SELECT * FROM news4;
指定 TEMPTABLE 確保先物化再聚合,避免 MERGE 模式語義錯誤。
總結:優化決策樹
- 子查詢 → 嘗試改寫為 JOIN
- JOIN 慢 → 檢查驅動表是否為小結果集、ON 條件是否走索引
- 多表聚合頻繁 → 考慮緩存表(寫入時計算,讀取 O(1))
- 單表過大 → 水平分表 + UNION ALL 視圖(TEMPTABLE 模式)
- 必須排序分頁 → 覆蓋索引 + 延遲關聯 或 游標分頁
優化無銀彈,但「理解優化器行為 + 業務妥協(緩存/冗餘/分表)」是解決大數據查詢的通用路徑。
推薦文章
- MySQL "Every derived table must have its…
- 關閉 MySQL/MariaDB Binlog 並清理歷史日誌文件操作指南
- MySQL 基礎操作入門全攻略:建庫建表、增刪改查、編碼、條件查詢
- MySQL 大檔案匯入報錯 "MySQL server has gone awa…
- SQL Server 索引使用情況監控:DMV 深度解析
- MySQL LENGTH() 與 CHAR_LENGTH() 差異詳解:中文長度…
- MySQL AUTO_INCREMENT 消失之謎:長時間閒置後自增屬性丟失的原…
- MySQL 數據導入導出實戰:mysqldump 核心參數詳解與最佳實踐
- MySQL LENGTH() 中文長度計算規則:UTF-8、GBK、Oracle…
- MySQL thread_cache_size 調優實戰:從 Threads_c…
copyright © 萬盛學電腦網 all rights reserved