您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MS SQL 資料庫
深度解析:聚集索引 vs 非聚集索引,原理、選擇與實戰誤區
核心概念
聚集索引
索引鍵值的邏輯順序決定表中數據行的物理存儲順序。類似電話簿按姓氏排序,一張表只能有一個聚集索引(可包含多列組合索引)。
優勢場景:
- 頻繁范圍查詢(如日期範圍),找到首行後後續行物理相鄰,極快。
- 頻繁按某列排序,聚集後免去每次排序開銷。
- 唯一值查找(如員工 ID),建立聚集索引或主鍵約束最快。
非聚集索引
索引邏輯順序與磁盤物理存儲順序不同。採用 B+ 樹結構,葉節點存儲索引鍵值及指向數據行的書籤(RID 或聚集索引鍵),需兩次查找:先找索引,再回表取數據。

(非聚集索引:葉節點含指針指向數據)
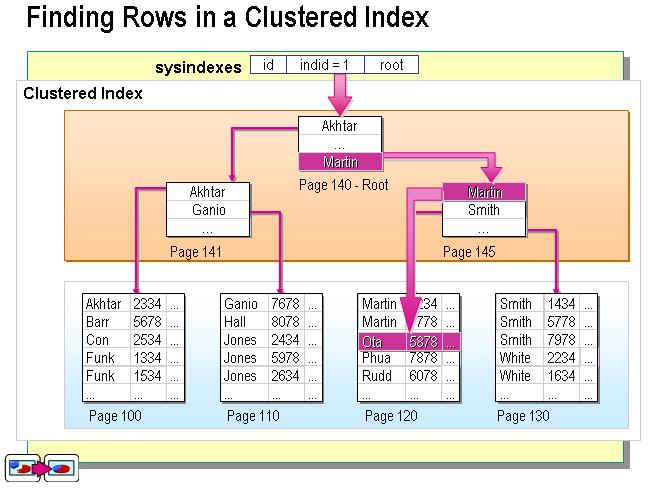
(聚集索引:葉節點即數據節點)
生動類比:字典
- 聚集索引 = 字典正文:按拼音排序,查「安」直接翻前面,查「張」翻後面。正文本身就是目錄,一步到位。
- 非聚集索引 = 部首檢字表:查不認識的字,先查部首得頁碼,再翻頁。目錄與正文分離,需兩步驟。
因此每張表只能有一個聚集索引,因為正文只能按一種順序排列。
何時選擇哪種索引(關鍵決策表)
| 動作描述 | 聚集索引 | 非聚集索引 |
|---|---|---|
| 列經常分組/排序 | ✓ | ✓ |
| 返回范圍數據 | ✓ | ✗ |
| 極少不同值 (如性別) | ✗ | ✗ |
| 少量不同值 | ✓ | ✗ |
| 大量不同值 | ✗ | ✓ |
| 頻繁更新的列 | ✗ | ✓ |
| 外鍵列 | ✓ | ✓ |
| 主鍵列 | ✓ | ✓ |
| 頻繁修改索引列 | ✗ | ✓ |
實戰誤區:主鍵 ≠ 聚集索引
SQL Server 預設在主鍵上建聚集索引,但這往往是資源浪費:
- ID 通常為自增代理鍵,業務查詢從不按 ID 篩選,無法發揮聚集索引范圍查詢優勢。
- 「大量不同值不宜建聚集索引」原則,自增 ID 違反此原則。
- 聚集索引極其寶貴(每表僅一個),應留給業務高頻范圍查詢列(如「日期」、「用戶名」)。
實測數據對比 (1000 萬行,近 3 個月 25 萬行)
| 方案 | SQL | 耗時 |
|---|---|---|
| 僅主鍵聚集,無時間過濾 | SELECT gid,fariqi,neibuyonghu,title FROM tgongwen | 128,470 ms (128 秒) |
| 主鍵聚集 + 日期非聚集 | SELECT ... WHERE fariqi > DATEADD(day,-90,GETDATE()) | 53,763 ms (54 秒) |
| 聚集索引建在日期列 | SELECT ... WHERE fariqi > DATEADD(day,-90,GETDATE()) | 2,423 ms (2 秒) |
差異高達 50 倍!若仍將聚集索引浪費在 ID 上,千萬級數據下網頁將直接超時。結論:聚集索引應服務於核心業務查詢模式,而非默認綁定主鍵。
推薦文章
- SQL Server 常用字串函數完整指南:從 SUBSTRING 到 STUF…
- SQL Server 表值函數效能陷阱:內聯 vs 多語句、執行計畫黑盒與優化策…
- SQL 字段值包含查詢:CHARINDEX 實現「被包含」反向匹配,替代多 OR…
- SQL Server 全文索引完整範例:以 pubs 資料庫為例的建立與查詢流程
- SQL Server 三大典型等待類型診斷與效能調校實戰案例
- C# 封裝 ADO.NET 通用資料存取類 MyDBase 實作教學
- SQL Server 大量匯入資料四大方案:SELECT INTO、Excel …
- SQL Server 查詢兩欄值完全相同且重複達 N 筆以上的資料
- SQL Server 系統表損壞修復實戰:DBCC CHECKDB 報錯 892…
- SQL Server 鎖機制深度解析:從紅綠燈類比到鎖升級實戰觀測
copyright © 萬盛學電腦網 all rights reserved