您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 資料庫 >> MS SQL 資料庫
破解 DISTINCT 與 ORDER BY 衝突:保留排序後首次出現順序的進階查寫法
問題情境:看似直觀的查詢卻報錯
資料表 Sample 包含 DepartmentId、Name 兩欄,呈現多對多關係。需求:先依 DepartmentId 排序,再取 Name 去重複值,並保留排序後的相對順序。期望結果:A, C, B。
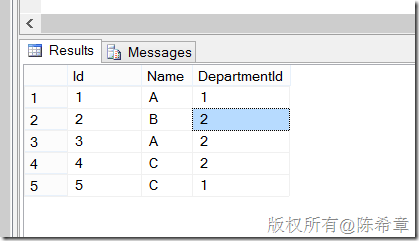
直覺寫法與失敗分析
嘗試 1:直接 DISTINCT + ORDER BY
SELECT DISTINCT name FROM Sample ORDER BY DepartmentId;錯誤:ORDER BY項目必須出現在SELECT DISTINCT清單中。
嘗試 2:將 DepartmentId 加入 SELECT
SELECT DISTINCT name, DepartmentId FROM Sample ORDER BY DepartmentId;結果錯誤:輸出含重複 Name (不同 DepartmentId 視為不同列),不符去重需求。
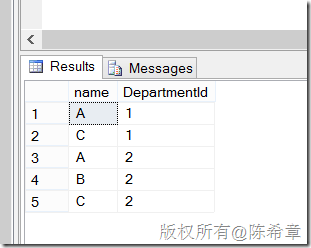
嘗試 3:子查詢先排序再去重
SELECT DISTINCT a.Name
FROM (SELECT TOP 100 PERCENT name FROM Sample ORDER BY DepartmentId) a;結果順序錯誤:輸出A, B, C而非期望的A, C, B。
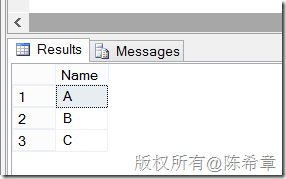
根因:DISTINCT 內建排序行為
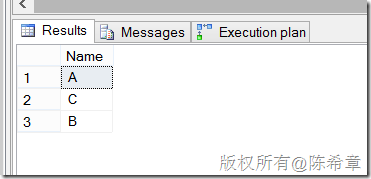
執行計畫揭示:DISTINCT 內部會執行排序去重 (Sort Distinct),此排序**不可控制**、且會覆蓋外層 ORDER BY。ORM 工具 (如 Entity Framework) 甚至會自動捨棄子查詢中的 ORDER BY。
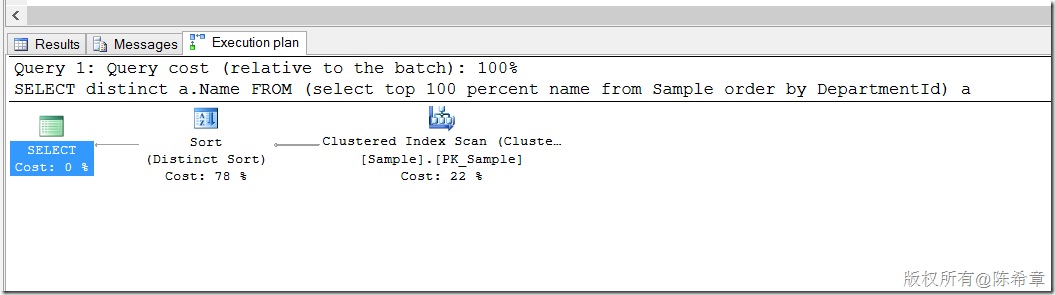
解決方案:ROW_NUMBER() 視窗函數標記首次出現
核心思路
- 依
DepartmentId排序 - 對每個
Name分區,按DepartmentId排序編號 (ROW_NUMBER() OVER (PARTITION BY Name ORDER BY DepartmentId)) - 篩選編號 = 1 的列 (即該 Name 在排序後的首次出現)
- 最終依
DepartmentId排序輸出
完整查詢
SELECT a.Name
FROM (
  SELECT TOP 100 PERCENT
    Name,
    DepartmentId,
    ROW_NUMBER() OVER (PARTITION BY Name ORDER BY DepartmentId) AS rn
  FROM Sample
  ORDER BY DepartmentId
) a
WHERE a.rn = 1
ORDER BY a.DepartmentId;
執行結果
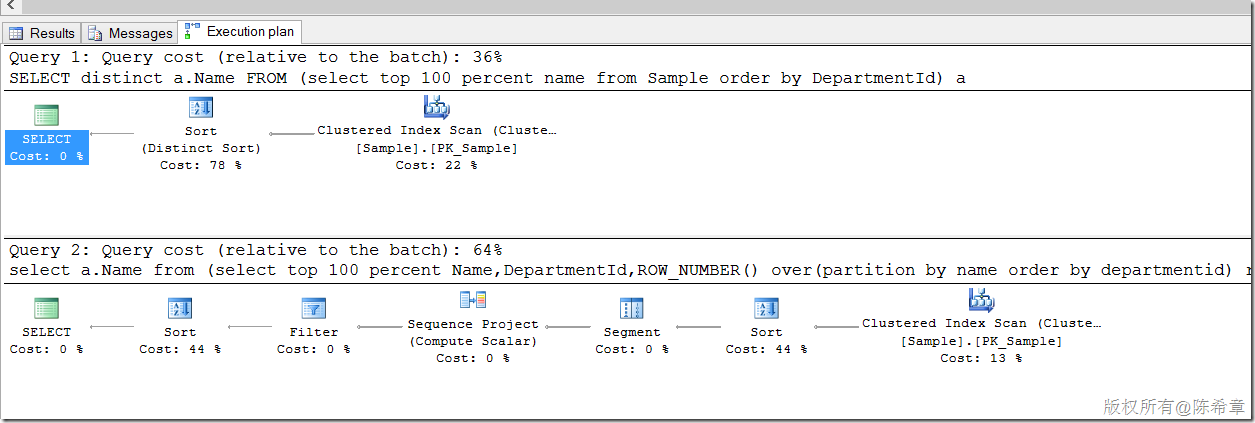
成功輸出 A, C, B,符合「先排序、再去重、保留相對順序」需求。
效能考量與替代寫法
效能分析
- 視窗函數需排序運算,成本高於單純 DISTINCT
- 執行計畫顯示額外
Segment、Sequence Project、Filter運算子 - 資料量大時,建議評估是否真正需要「保留排序後首現順序」這特殊語意
替代方案比較
| 寫法 | 語法 | 適用場景 | 效能 |
|---|---|---|---|
| ROW_NUMBER (本文方案) | 標準 SQL:2003,SQL 2005+ 支援 | 嚴格保留排序後首現順序 | 中 |
| GROUP BY + MIN/MAX | SELECT Name, MIN(DepartmentId) AS FirstDept FROM Sample GROUP BY Name ORDER BY FirstDept | 只需任一關聯 DepartmentId,不在乎完整順序 | 優 |
| 應用層去重 | 資料庫只回傳排序後完整集合,應用層遍歷去重 | 資料量小、邏輯複雜、需極致彈性 | 視網路/記憶體 |