您现在的位置: 萬盛學電腦網 >> 程式設計 > >> 網頁製作 >> 互動設計
為什麼用戶難以開口說話?語音交互的隱形門檻與破解之道
老羅曾說:「語音識別技術上,Siri 或其模仿者從根上就錯了,所以都只是熱鬧一陣,幾乎沒人認真用(因為不好用+用起來顯得巨傻)。」雖言辭偏激,但「沒人認真用」即「不願開口」值得深思。語音識別這個「正統太子」發展至今,試圖滲透生活,卻發現並不如傳說神奇:從語音機器人到 Siri 再到 Google Glass,每次問世引關注,隨時間平息。到底是什麼讓我們覺得巨傻而難開金口?
市場現狀
常見語音類產品分三大領域:
- 手機:微信語音、語音助手、聽歌搜尋
- PC:語音聊天、外語教學軟體、盲人輔助軟體
- 其他設備:Google Glass、車載系統

圖1:寶馬車載語音控制系統,駕駛員按方向盤鍵啟動,聲音控制發送訊息、撥電話等。
圖2:Google Glass。
圖3:盲人閱讀器。
圖4:Duolingo 外語學習軟體,語音練習聽說。
使用習慣分析
有的涉及識別,有的不涉及,但可發現有趣現象:
- 手機領域,聽歌搜尋識別準確度高;
- 微信教育下,公開場合對手機說話越來越自然,用戶習慣形成;
- 外語教學、盲人輔助有特有市場、高壁壘、易獲成績;
- 其他設備雖新興,但因設備條件與場景特殊性、前瞻性,屬發展滲透趨勢。
問題與解決方案
透過以上發現,找出人機語音交互痛點,用設計手段提升開口意願:
識別準確率
環境噪音、硬體條件、技術限制降低準確率。與人類表達/理解能力差異相比,技術仍有差距,試幾次後用戶變得咬文嚼字、小心翼翼。
交互角度拆解「小心翼翼」:
- 不知道對準哪裡說: 最大 CTA 語音按鈕置於麥克風附近。iPhone 麥克風在底部,Siri 按鈕與聲波動效回饋也在底部,用戶自然形成對準底部說話的條件反射。
- 不知道何時開始/結束: 長按錄入。長按已成習慣,適用社交與識別場景;開始/結束由人控制,比機器判斷更準,利於屏蔽噪音(如百度語音助手 Android 版)。
- 識別語言不清晰: 有效提示引導。識別結果不唯一時,用置信區間給出多結果建議,或提供可修改部分與候選項,降低挫敗感與修改成本(如百度地圖語音輸入「鵬寰大廈」後的建議列表)。
情感因素
人機對話三階段:人語音輸入 → 識別分析 → 機器回答反饋。
體驗設計角度,第一階段特別在公共場合,對著機器咬文嚼字顯奇特。交互層面可:
- 提供備選輸入: 鍵盤輸入。
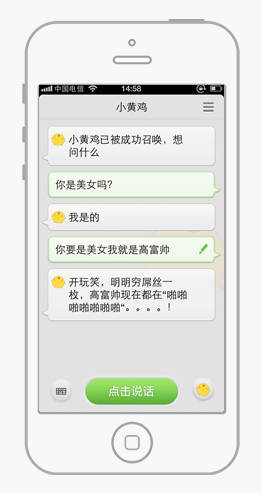
- 分層收斂: 進入足夠垂直場景,減少干擾(如百度語音助手「召喚小黃雞」進入對話場景,拋開無關事,發揮想像力可替換任意場景)。
- 模擬既有習慣: 拿手機到耳邊具針對性指向打電話場景。錘子系統語音撥號:直接拿到耳邊說姓名即撥打,省步驟、免顧慮。
第三階段機器回答因固定語調、缺乏情感顯冰冷,可採擬人化場景設計或豐富語音播報類型舒緩神經(如天氣通提供方言/明星播報,增趣味性)。
其他切入點
- 產品定位: 教育、助殘、純趣味探索,皆能找到切入點。
- 特殊場合: 肢體/視線被佔用時(開車操作車載功能、做飯參考菜譜),語音交流是優解。
- 細分場景優化: 如建提醒、聽播報。
- 上一篇程序編程: 交互設計如何傳遞身份認同:百度手機瀏覽器留住用戶的三大實戰
- 下一篇程序編程: 互聯網設計趨勢演進:從扁平化到雜誌化的視覺語言革命
推薦文章
copyright © 萬盛學電腦網 all rights reserved